
Содержание
- Что такое глубокое обучение?
- Где глубокое обучение соприкасается с бизнесом?
- 1. Считывание документов и чеков: оптическое распознавание символов
- 2. Классификация: записать расход в нужное место
- 3. Прогнозирование: предвидеть бюджет и денежный поток
- В чём разница между глубоким обучением и классическим машинным обучением?
- На что обратить внимание при внедрении в организации?
- Часто задаваемые вопросы
- Глубокое обучение и искусственный интеллект — это одно и то же?
- Как глубокое обучение используется в корпоративном управлении расходами?
- Чтобы воспользоваться этой технологией, нужно ли обучать собственную модель?
- С каким объёмом данных работает модель?
- Заключение: перенесите глубокое обучение в ваш процесс управления расходами
Глубокое обучение — это подход машинного обучения, основанный на многослойных искусственных нейронных сетях, вдохновлённых нервными клетками человеческого мозга. В этой статье мы кратко изложим, что такое глубокое обучение, а затем сосредоточимся на главном вопросе: где эта технология соприкасается с повседневными финансовыми процессами и управлением расходами предприятия? Считывание чеков и счетов, классификация расходов и прогнозирование бюджета — это три основные области, где глубокое обучение конкретно ложится на стол финансовых команд.
Что такое глубокое обучение?
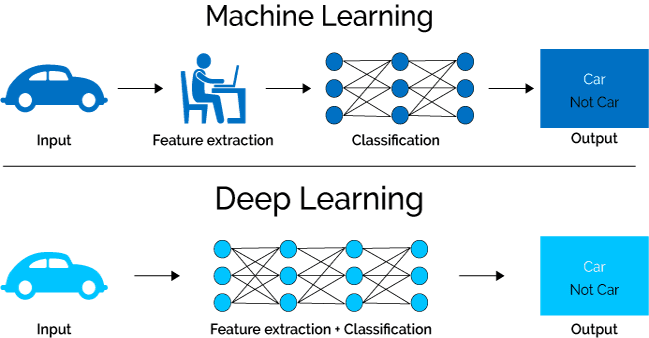
В отличие от классического машинного обучения, глубокое обучение использует искусственные нейронные сети, состоящие из большого числа слоёв. Слово «глубокое» указывает именно на большое количество этих слоёв. Первые слои улавливают простые подсказки в данных (линии на изображении чека, контуры символов), а более глубокие слои изучают более абстрактные понятия (это итоговая сумма, а это имя поставщика).
Главное отличие таково: в традиционных методах эксперт вручную определяет, на какие признаки данных смотреть. Глубокое же обучение берёт сырые данные напрямую и само выясняет, что важно. Эта способность даёт большое преимущество на данных, которые не помещаются в аккуратную таблицу, — таких как изображения, звук и свободный текст. Мятые чеки, счета в разных форматах и пояснительные тексты, которые каждый день проходят через руки бухгалтерской команды, — это именно такой тип данных.
Процесс обучения нейронной сети тоже идёт по интуитивной логике: модель делает прогноз, измеряется ошибка между прогнозом и реальным значением, и внутренние настройки сети обновляются в сторону уменьшения этой ошибки. После тысяч повторений модель, например, всё точнее считывает сумму на чеке.
Где глубокое обучение соприкасается с бизнесом?
Архитектурные детали глубокого обучения (свёрточные сети для изображений, рекуррентные сети для последовательных данных и модели с механизмом внимания) — это дело технических команд. Для финансового руководителя важно то, какую работу берут на себя эти архитектуры. Рассмотрим на трёх основных примерах.
1. Считывание документов и чеков: оптическое распознавание символов
Место, где глубокое обучение наиболее непосредственно соприкасается с корпоративными финансами, — это считывание документов. Технология оптического распознавания символов способна с высокой точностью распознавать различные шрифты, рукописный текст и даже текст на мятых или низкокачественных чеках. Современные системы не только считывают символы: они понимают структуру документа, разбирают таблицу и разделяют по полям информацию о дате, сумме, налоговой ставке и поставщике.
Для финансовой команды результат очевиден: ручной ввод в систему собранных сотрудниками чеков и счетов — это и медленная, и подверженная ошибкам работа. Считывание документов на основе глубокого обучения сокращает этот этап до секунд, устраняя у самого источника проблемы утерянных чеков, неверных сумм и просроченных деклараций. Нагрузку ручного ввода на компанию мы отдельно рассмотрели в статье о скрытой временной стоимости ввода расходов.
2. Классификация: записать расход в нужное место
Вторая крупная область применения глубокого обучения — классификация. Отнести расход к категории «питание», «транспорт» или «проживание» кажется простым; однако делать это вручную и последовательно на тысячах строк данных о расходах сложно. Модели, обучающиеся на тексте и изображениях, автоматически предлагают правильную категорию и правильный центр затрат для расхода, опираясь на содержимое чека, имя поставщика и сумму.
Правильная классификация — это не только вопрос порядка: видимость по категориям делает возможным автоматическую проверку правил политики расходов. Не соответствующий политике расход попадает к руководителю уже отмеченным на этапе согласования.
Расширением той же инфраструктуры классификации является выявление отклонений: поскольку модель изучила обычную структуру расходов, она может отмечать такие ситуации, как дублирующиеся чеки, завышенные суммы или необычные поставщики. Процессную сторону этой темы мы подробно разобрали в статье о злоупотреблениях с расходами.
3. Прогнозирование: предвидеть бюджет и денежный поток
Третья область — прогнозирование. Модели глубокого обучения, работающие с последовательными данными, используются для прогнозирования хода расходов будущего периода на основе исторических рядов расходов. Это даёт прямой вклад в две ключевые задачи финансовой команды: на стороне управления бюджетом — заранее увидеть отклонения к концу периода; на стороне денежного потока — точнее планировать выплаты предстоящих месяцев.
Здесь нужно правильно выстроить ожидания: модели прогнозирования не дают точных цифр; они дают тенденцию и диапазон. И именно в этом их ценность — они уменьшают неожиданности и приближают решение.
В чём разница между глубоким обучением и классическим машинным обучением?
Эти два понятия часто путают; с точки зрения бизнеса различия можно резюмировать так:
| Характеристика | Классическое машинное обучение | Глубокое обучение |
|---|---|---|
| Извлечение признаков | Эксперт определяет вручную | Модель сама учится на данных |
| Потребность в данных | Может работать с меньшим объёмом данных | Требует большого набора данных |
| Подходящий тип данных | Упорядоченные табличные данные | Свободные данные: изображения, текст, звук |
| Объяснимость | Проще отследить решения | Обоснование решений более закрыто |
Глубокое обучение является подмножеством машинного обучения. В задачах со свободными данными, таких как считывание изображений чеков, глубокое обучение с большим отрывом превосходит; на малых и упорядоченных наборах данных классические методы всё ещё могут быть эффективны и более экономичны.
На что обратить внимание при внедрении в организации?
При переносе глубокого обучения в финансовые процессы нужно обратить внимание на три момента:
- Качество данных: модель настолько хороша, насколько хороши данные, которыми её питают. Система, построенная на разрозненных данных о расходах с неполной разметкой, не вызывает доверия; сначала нужно установить дисциплину данных.
- Объяснимость: в подконтрольных областях, таких как финансы, «так сказала модель» — недостаточное обоснование. Предпочтительны схемы, где автоматические решения (например, отметка о расходе) сочетаются с одобрением человека.
- Решение «создать или купить»: обучение собственной модели требует данных, специализированного оборудования и команды экспертов. Для большинства предприятий верный путь — использовать решение для управления расходами, которое уже предлагает считывание документов и классификацию, а создавать собственную модель только при наличии действительно отличительной потребности.
Часто задаваемые вопросы
Глубокое обучение и искусственный интеллект — это одно и то же?
Нет. Искусственный интеллект — самое широкое понятие; машинное обучение — его подраздел, а глубокое обучение — подмножество машинного обучения.
Как глубокое обучение используется в корпоративном управлении расходами?
Тремя основными способами: автоматическое считывание чеков и счетов с помощью оптического распознавания символов, автоматическая классификация расходов по категориям и центрам затрат, прогнозирование бюджета и денежного потока на основе исторических данных. К этому добавляется выявление отклонений (отметка дублирующихся или не соответствующих политике расходов).
Чтобы воспользоваться этой технологией, нужно ли обучать собственную модель?
В большинстве случаев нет. Считывание документов и классификация расходов — это области, где готовые решения уже зрелые; обучение собственной модели требует крупных вложений в данные и экспертизу и, как правило, оправдано только при очень специфических потребностях.
С каким объёмом данных работает модель?
Зависит от задачи. Для простых задач классификации может хватить нескольких тысяч примеров; сложные задачи с изображениями и языком требуют гораздо большего. Перенос обучения, опирающийся на предварительно обученные модели, позволяет получать хорошие результаты и при малом объёме данных.
Заключение: перенесите глубокое обучение в ваш процесс управления расходами
Глубокое обучение перестало быть академическим любопытством и вошло в повседневный набор инструментов финансовой команды. Считывание документов устраняет ручной ввод, классификация автоматизирует проверку политик, прогнозирование приближает бюджетный и денежный план. Masraff благодаря технологии считывания документов на основе искусственного интеллекта за считанные секунды оцифровывает ваши чеки и счета, автоматически классифицирует ваши расходы и управляет вашим процессом расходов от начала до конца. Чтобы увидеть, что можно сделать с вашими собственными данными о расходах, свяжитесь с нами.