
Inhaltsverzeichnis
- Was ist Deep Learning?
- Wo berührt Deep Learning das Unternehmen?
- 1. Beleg- und Dokumentenlesen: optische Zeichenerkennung
- 2. Klassifizierung: die Ausgabe richtig verbuchen
- 3. Prognose: Budget und Cashflow vorhersehen
- Was ist der Unterschied zwischen Deep Learning und klassischem maschinellen Lernen?
- Worauf ist bei der Einführung im Unternehmen zu achten?
- Häufig gestellte Fragen
- Sind Deep Learning und künstliche Intelligenz dasselbe?
- Wie wird Deep Learning im betrieblichen Ausgabenmanagement eingesetzt?
- Müssen wir ein eigenes Modell trainieren, um von dieser Technologie zu profitieren?
- Mit wie vielen Daten arbeitet ein Modell?
- Fazit: Bringen Sie Deep Learning in Ihren Ausgabenprozess
Deep Learning ist ein Ansatz des maschinellen Lernens, der auf mehrschichtigen künstlichen neuronalen Netzen basiert, die von den Nervenzellen des menschlichen Gehirns inspiriert sind. In diesem Beitrag fassen wir kurz zusammen, was Deep Learning ist, und konzentrieren uns dann auf die eigentliche Frage: Wo berührt diese Technologie die alltäglichen Finanz- und Ausgabenprozesse eines Unternehmens? Das Lesen von Belegen und Rechnungen, die Klassifizierung von Ausgaben und die Budgetprognose sind die drei Hauptbereiche, in denen Deep Learning ganz konkret auf dem Tisch des Finanzteams landet.
Was ist Deep Learning?
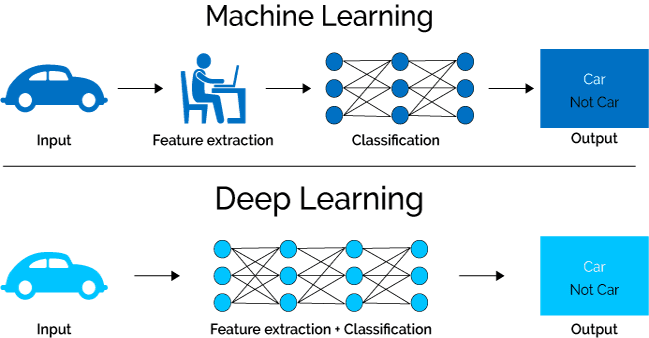
Im Gegensatz zum klassischen maschinellen Lernen verwendet Deep Learning künstliche neuronale Netze, die aus vielen Schichten bestehen. Das Wort „deep" (tief) verweist auf die große Zahl dieser Schichten. Die ersten Schichten erfassen einfache Hinweise in den Daten (Linien in einem Belegbild, Konturen von Zeichen), während die tieferen Schichten abstraktere Konzepte lernen (dies ist ein Gesamtbetrag, das ist ein Lieferantenname).
Der eigentliche Unterschied ist folgender: Bei traditionellen Methoden definiert ein Experte manuell, welche Merkmale der Daten betrachtet werden. Deep Learning hingegen nimmt die Rohdaten direkt entgegen und entdeckt selbstständig, was wichtig ist. Diese Fähigkeit verschafft einen großen Vorteil bei Daten, die nicht in eine geordnete Tabelle passen — etwa Bilder, Audio und Freitext. Die zerknitterten Belege, Rechnungen in unterschiedlichen Formaten und Beschreibungstexte, die täglich durch die Hände eines Buchhaltungsteams gehen, sind genau diese Art von Daten.
Auch der Lernprozess des neuronalen Netzes folgt einer intuitiven Logik: Das Modell trifft eine Vorhersage, der Fehler zwischen Vorhersage und tatsächlichem Wert wird gemessen, und die internen Einstellungen des Netzes werden so angepasst, dass dieser Fehler kleiner wird. Nach Tausenden von Wiederholungen liest das Modell zum Beispiel den Betrag auf einem Beleg immer treffsicherer.
Wo berührt Deep Learning das Unternehmen?
Die architektonischen Details des Deep Learning (Convolutional Networks für Bilddaten, rekurrente Netze und Modelle mit Aufmerksamkeitsmechanismus für sequenzielle Daten) sind Sache der technischen Teams. Für Finanzverantwortliche zählt, welche Aufgaben diese Architekturen übernehmen. Betrachten wir drei zentrale Beispiele.
1. Beleg- und Dokumentenlesen: optische Zeichenerkennung
Der Ort, an dem Deep Learning die Unternehmensfinanzen am unmittelbarsten berührt, ist das Lesen von Dokumenten. Die Technologie der optischen Zeichenerkennung kann unterschiedliche Schriftarten, Handschrift und sogar Texte auf zerknitterten oder qualitativ schlechten Belegen mit hoher Genauigkeit erkennen. Moderne Systeme lesen nicht nur Zeichen; sie verstehen die Struktur des Dokuments, zerlegen Tabellen und ordnen Datum, Betrag, Steuersatz und Lieferanteninformationen den richtigen Feldern zu.
Für das Finanzteam bedeutet das ganz konkret: Die manuelle Eingabe der von Mitarbeitenden gesammelten Belege und Rechnungen ist langsam und fehleranfällig. Deep-Learning-basiertes Dokumentenlesen verkürzt diesen Schritt auf Sekunden und reduziert verlorene Belege, falsche Beträge und verspätete Einreichungen an der Quelle. Die Belastung der manuellen Eingabe für das Unternehmen haben wir im Beitrag über die versteckten Zeitkosten der Ausgabenerfassung behandelt.
2. Klassifizierung: die Ausgabe richtig verbuchen
Das zweite große Arbeitsfeld des Deep Learning ist die Klassifizierung. Eine Ausgabe der Kategorie „Verpflegung", „Transport" oder „Unterkunft" zuzuordnen, wirkt simpel; doch dies bei Tausenden von Ausgabenzeilen manuell und konsistent zu tun, ist schwierig. Modelle, die aus Text und Bildern lernen, schlagen anhand des Beleginhalts, des Lieferantennamens und des Betrags automatisch die richtige Kategorie und die richtige Kostenstelle vor.
Eine korrekte Klassifizierung ist nicht nur eine Frage der Ordnung: Sichtbarkeit auf Kategorieebene ermöglicht die automatische Prüfung der Regeln der Ausgabenrichtlinie. Eine richtlinienwidrige Ausgabe erreicht die Führungskraft bereits in der Genehmigungsphase markiert.
Eine Erweiterung derselben Klassifizierungsinfrastruktur ist die Anomalieerkennung: Da das Modell das übliche Ausgabemuster gelernt hat, kann es Fälle wie doppelte Belege, überhöhte Beträge oder ungewöhnliche Lieferanten markieren. Die Prozessseite dieses Themas haben wir im Beitrag über Spesenmissbrauch ausführlich untersucht.
3. Prognose: Budget und Cashflow vorhersehen
Der dritte Bereich ist die Prognose. Deep-Learning-Modelle, die mit sequenziellen Daten arbeiten, werden eingesetzt, um aus historischen Ausgabenreihen den Ausgabenverlauf der kommenden Periode vorherzusagen. Das liefert direkten Input für zwei Kernaufgaben des Finanzteams: beim Budgetmanagement Periodenabweichungen frühzeitig zu erkennen; beim Cashflow die Abflüsse der kommenden Monate treffsicherer zu planen.
Hier gilt es, die Erwartungen richtig zu setzen: Prognosemodelle liefern keine exakten Zahlen, sondern Trends und Bandbreiten. Genau darin liegt ihr Wert — sie verkleinern die Überraschung und ziehen die Entscheidung vor.
Was ist der Unterschied zwischen Deep Learning und klassischem maschinellen Lernen?
Die beiden Begriffe werden oft verwechselt; aus Unternehmenssicht lassen sich die Unterschiede so zusammenfassen:
| Merkmal | Klassisches maschinelles Lernen | Deep Learning |
|---|---|---|
| Merkmalsextraktion | Wird von einem Experten manuell definiert | Das Modell lernt sie selbst aus den Daten |
| Datenbedarf | Kommt mit weniger Daten aus | Verlangt große Datensätze |
| Geeigneter Datentyp | Strukturierte Tabellendaten | Unstrukturierte Daten wie Bilder, Text, Audio |
| Erklärbarkeit | Entscheidungen sind leichter nachvollziehbar | Die Begründung der Entscheidungen ist weniger transparent |
Deep Learning ist eine Teilmenge des maschinellen Lernens. Bei Aufgaben mit unstrukturierten Daten wie dem Lesen von Belegbildern ist Deep Learning klar überlegen; bei kleinen und strukturierten Datensätzen können klassische Methoden weiterhin wirksam und wirtschaftlicher sein.
Worauf ist bei der Einführung im Unternehmen zu achten?
Wer Deep Learning in Finanzprozesse bringt, sollte auf drei Punkte achten:
- Datenqualität: Ein Modell ist nur so gut wie die Daten, mit denen es gefüttert wird. Ein System, das auf unordentlichen, lückenhaft etikettierten Ausgabendaten aufbaut, schafft kein Vertrauen; zuerst muss die Datendisziplin stehen.
- Erklärbarkeit: In prüfungspflichtigen Bereichen wie den Finanzen ist „das Modell hat es so entschieden" keine ausreichende Begründung. Vorzuziehen sind Konstellationen, in denen automatische Entscheidungen (etwa das Markieren einer Ausgabe) mit menschlicher Freigabe kombiniert werden.
- Make-or-Buy-Entscheidung: Ein eigenes Modell zu trainieren erfordert Daten, spezielle Hardware und ein Expertenteam. Für die meisten Unternehmen ist der richtige Weg, eine Ausgabenmanagement-Lösung zu nutzen, die Dokumentenlesen und Klassifizierung fertig mitbringt — und ein eigenes Modell nur dann aufzubauen, wenn ein wirklich differenzierender Bedarf besteht.
Häufig gestellte Fragen
Sind Deep Learning und künstliche Intelligenz dasselbe?
Nein. Künstliche Intelligenz ist der breiteste Begriff; maschinelles Lernen ist eines ihrer Teilgebiete, und Deep Learning ist wiederum eine Teilmenge des maschinellen Lernens.
Wie wird Deep Learning im betrieblichen Ausgabenmanagement eingesetzt?
Auf drei Hauptwegen: automatisches Lesen von Belegen und Rechnungen per optischer Zeichenerkennung, automatische Klassifizierung der Ausgaben nach Kategorie und Kostenstelle sowie Budget- und Cashflow-Prognosen aus historischen Daten. Hinzu kommt die Anomalieerkennung (Markieren doppelter oder richtlinienwidriger Ausgaben).
Müssen wir ein eigenes Modell trainieren, um von dieser Technologie zu profitieren?
In den meisten Fällen nein. Dokumentenlesen und Ausgabenklassifizierung sind Bereiche, in denen fertige Lösungen ausgereift sind; ein eigenes Modell zu trainieren erfordert große Investitionen in Daten und Fachwissen und lohnt sich in der Regel nur bei sehr spezifischen Anforderungen.
Mit wie vielen Daten arbeitet ein Modell?
Das hängt vom Problem ab. Für einfache Klassifizierungsaufgaben können einige Tausend Beispiele genügen; komplexe Bild- und Sprachaufgaben verlangen deutlich mehr. Transferlernen auf Basis vortrainierter Modelle macht es möglich, auch mit wenigen Daten gute Ergebnisse zu erzielen.
Fazit: Bringen Sie Deep Learning in Ihren Ausgabenprozess
Deep Learning hat den Status einer akademischen Kuriosität hinter sich gelassen und ist im täglichen Werkzeugkasten des Finanzteams angekommen. Dokumentenlesen beseitigt die manuelle Eingabe, Klassifizierung automatisiert die Richtlinienprüfung, Prognosen ziehen Budget- und Liquiditätsplanung nach vorn. Masraff digitalisiert Ihre Belege und Rechnungen mit KI-gestützter Dokumentenlesetechnologie in Sekunden, klassifiziert Ihre Ausgaben automatisch und steuert Ihren Ausgabenprozess von Anfang bis Ende. Nehmen Sie Kontakt mit uns auf, um zu sehen, was mit Ihren eigenen Ausgabendaten möglich ist.