
Tabla de Contenidos
- ¿Qué es el deep learning?
- ¿Dónde toca el deep learning a la empresa?
- 1. Lectura de documentos y recibos: reconocimiento óptico de caracteres
- 2. Clasificación: imputar el gasto al lugar correcto
- 3. Previsión: anticipar el presupuesto y el flujo de caja
- ¿Cuál es la diferencia entre el deep learning y el aprendizaje automático clásico?
- ¿A qué hay que prestar atención al implantarlo en la empresa?
- Preguntas frecuentes
- ¿Son lo mismo el deep learning y la inteligencia artificial?
- ¿Cómo se utiliza el deep learning en la gestión de gastos corporativos?
- ¿Necesitamos entrenar nuestro propio modelo para aprovechar esta tecnología?
- ¿Con cuántos datos funciona un modelo?
- Conclusión: lleve el deep learning a su proceso de gastos
El deep learning (aprendizaje profundo) es un enfoque de aprendizaje automático basado en redes neuronales artificiales multicapa inspiradas en las células nerviosas del cerebro humano. En este artículo resumiremos brevemente qué es el deep learning y luego nos centraremos en la pregunta de fondo: ¿dónde toca esta tecnología los procesos financieros y de gestión de gastos del día a día de una empresa? La lectura de recibos y facturas, la clasificación de los gastos y la previsión presupuestaria son las tres grandes áreas en las que el deep learning aterriza de forma concreta en la mesa del equipo financiero.
¿Qué es el deep learning?
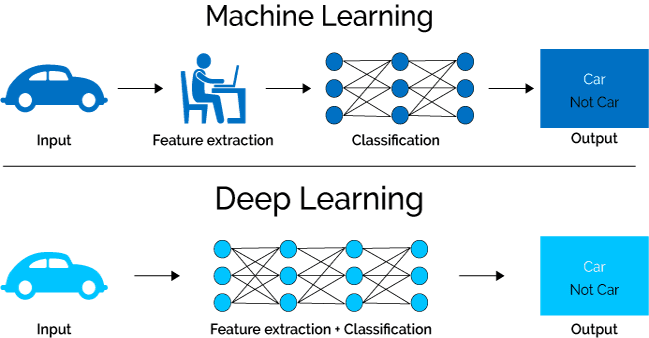
A diferencia del aprendizaje automático clásico, el deep learning utiliza redes neuronales artificiales compuestas por muchas capas. La palabra «deep» (profundo) alude precisamente a la gran cantidad de esas capas. Las primeras capas captan pistas simples en los datos (las líneas de la imagen de un recibo, los trazos de los caracteres), mientras que las capas profundas aprenden conceptos más abstractos (esto es un importe total, aquello es el nombre de un proveedor).
La diferencia esencial es esta: en los métodos tradicionales, un experto define a mano qué características de los datos hay que observar. El deep learning, en cambio, toma directamente los datos en bruto y descubre por sí mismo qué es lo importante. Esta capacidad ofrece una gran ventaja con datos que no caben en una tabla ordenada, como imágenes, audio y texto libre. Los recibos arrugados, las facturas en formatos diversos y los textos descriptivos que pasan cada día por las manos de un equipo de contabilidad son exactamente ese tipo de datos.
El proceso de aprendizaje de la red neuronal también sigue una lógica intuitiva: el modelo hace una predicción, se mide el error entre la predicción y el valor real, y los ajustes internos de la red se actualizan en la dirección que reduce ese error. Tras miles de repeticiones, el modelo lee, por ejemplo, el importe de un recibo con una precisión cada vez mayor.
¿Dónde toca el deep learning a la empresa?
Los detalles arquitectónicos del deep learning (redes convolucionales para datos de imagen, redes recurrentes y modelos con mecanismo de atención para datos secuenciales) son asunto de los equipos técnicos. Lo que importa al responsable financiero es qué tareas asumen estas arquitecturas. Veámoslo con tres ejemplos principales.
1. Lectura de documentos y recibos: reconocimiento óptico de caracteres
El punto donde el deep learning toca de forma más directa las finanzas corporativas es la lectura de documentos. La tecnología de reconocimiento óptico de caracteres puede reconocer con gran precisión distintos tipos de letra, escritura a mano e incluso el texto de recibos arrugados o de baja calidad. Los sistemas modernos no se limitan a leer caracteres: comprenden la estructura del documento, descomponen las tablas y separan en campos la fecha, el importe, el tipo impositivo y los datos del proveedor.
Para el equipo financiero, la traducción es clara: introducir a mano en el sistema los recibos y facturas que recopilan los empleados es una tarea lenta y propensa a errores. La lectura de documentos basada en deep learning reduce este paso a segundos y disminuye en origen los recibos perdidos, los importes erróneos y las presentaciones tardías. Tratamos la carga que supone la entrada manual para la empresa en el artículo sobre el coste oculto en tiempo del registro de gastos.
2. Clasificación: imputar el gasto al lugar correcto
La segunda gran área de trabajo del deep learning es la clasificación. Asignar un gasto a la categoría «comidas», «transporte» o «alojamiento» parece sencillo; pero hacerlo a mano y de forma coherente en miles de líneas de gasto es difícil. Los modelos que aprenden de texto e imágenes proponen automáticamente la categoría correcta y el centro de coste adecuado a partir del contenido del recibo, el nombre del proveedor y el importe.
Una clasificación correcta no es solo cuestión de orden: la visibilidad por categorías hace posible la supervisión automática de las reglas de la política de gastos. Un gasto fuera de política llega al responsable ya marcado en la propia fase de aprobación.
Una extensión de esa misma infraestructura de clasificación es la detección de anomalías: como el modelo ha aprendido el patrón habitual de gasto, puede señalar casos como recibos duplicados, importes inflados o proveedores inusuales. Analizamos en detalle la vertiente de proceso de este tema en el artículo sobre el fraude en los gastos.
3. Previsión: anticipar el presupuesto y el flujo de caja
La tercera área es la previsión. Los modelos de deep learning que trabajan con datos secuenciales se utilizan para anticipar la evolución del gasto del próximo periodo a partir de las series históricas de gastos. Esto alimenta directamente dos tareas esenciales del equipo financiero: en el lado de la gestión presupuestaria, detectar pronto las desviaciones de fin de periodo; en el lado del flujo de caja, planificar con más acierto las salidas de los próximos meses.
Aquí conviene calibrar bien las expectativas: los modelos de previsión no dan cifras exactas; dan tendencias y rangos. Y precisamente ahí reside su valor: reducen la sorpresa y adelantan la decisión.
¿Cuál es la diferencia entre el deep learning y el aprendizaje automático clásico?
Ambos conceptos se confunden a menudo; desde la óptica de la empresa, sus diferencias pueden resumirse así:
| Característica | Aprendizaje automático clásico | Deep learning |
|---|---|---|
| Extracción de características | La define un experto a mano | El modelo la aprende por sí mismo de los datos |
| Necesidad de datos | Puede funcionar con menos datos | Exige grandes conjuntos de datos |
| Tipo de datos adecuado | Datos tabulares estructurados | Datos libres como imágenes, texto y audio |
| Explicabilidad | Las decisiones son más fáciles de rastrear | La justificación de las decisiones es más opaca |
El deep learning es un subconjunto del aprendizaje automático. En tareas con datos no estructurados, como leer imágenes de recibos, el deep learning es claramente superior; en conjuntos de datos pequeños y estructurados, los métodos clásicos siguen siendo eficaces y pueden resultar más económicos.
¿A qué hay que prestar atención al implantarlo en la empresa?
Al llevar el deep learning a los procesos financieros conviene vigilar tres puntos:
- Calidad de los datos: un modelo es tan bueno como los datos con los que se alimenta. Un sistema construido sobre datos de gasto desordenados y mal etiquetados no inspira confianza; primero hay que instaurar la disciplina de datos.
- Explicabilidad: en ámbitos sujetos a auditoría como las finanzas, «lo dijo el modelo» no es justificación suficiente. Deben preferirse los esquemas en los que las decisiones automáticas (por ejemplo, marcar un gasto) se combinan con la aprobación humana.
- Decisión de construir o comprar: entrenar un modelo propio exige datos, hardware especializado y un equipo experto. Para la mayoría de las empresas, el camino correcto es usar una solución de gestión de gastos que ofrezca de serie la lectura de documentos y la clasificación, y construir un modelo propio solo si existe una necesidad realmente diferenciadora.
Preguntas frecuentes
¿Son lo mismo el deep learning y la inteligencia artificial?
No. La inteligencia artificial es el concepto más amplio; el aprendizaje automático es una de sus ramas, y el deep learning es a su vez un subconjunto del aprendizaje automático.
¿Cómo se utiliza el deep learning en la gestión de gastos corporativos?
De tres formas principales: lectura automática de recibos y facturas mediante reconocimiento óptico de caracteres, clasificación automática de los gastos por categoría y centro de coste, y previsión del presupuesto y del flujo de caja a partir de datos históricos. A ello se suma la detección de anomalías (marcado de gastos duplicados o fuera de política).
¿Necesitamos entrenar nuestro propio modelo para aprovechar esta tecnología?
En la mayoría de los casos, no. La lectura de documentos y la clasificación de gastos son áreas en las que las soluciones listas para usar han madurado; entrenar un modelo propio requiere grandes inversiones en datos y especialización, y por lo general solo tiene sentido ante necesidades muy singulares.
¿Con cuántos datos funciona un modelo?
Depende del problema. Para tareas de clasificación sencillas pueden bastar unos pocos miles de ejemplos; las tareas complejas de imagen y lenguaje exigen muchos más. El aprendizaje por transferencia, que parte de modelos preentrenados, permite obtener buenos resultados incluso con pocos datos.
Conclusión: lleve el deep learning a su proceso de gastos
El deep learning ha dejado de ser una curiosidad académica para entrar en el conjunto de herramientas cotidiano del equipo financiero. La lectura de documentos elimina la entrada manual, la clasificación automatiza el control de la política de gastos y la previsión adelanta la planificación del presupuesto y de la tesorería. Masraff digitaliza sus recibos y facturas en segundos con su tecnología de lectura de documentos impulsada por IA, clasifica sus gastos automáticamente y gestiona su proceso de gastos de principio a fin. Póngase en contacto con nosotros para descubrir qué puede hacerse con sus propios datos de gasto.