
Cuprins
- Ce este învățarea profundă?
- Unde atinge învățarea profundă afacerea?
- 1. Citirea documentelor și a bonurilor: recunoașterea optică a caracterelor
- 2. Clasificarea: a înregistra cheltuiala la locul potrivit
- 3. Prognozarea: a anticipa bugetul și fluxul de numerar
- Care este diferența dintre învățarea profundă și învățarea automată clasică?
- La ce trebuie să fim atenți când o implementăm în organizație?
- Întrebări frecvente
- Învățarea profundă și inteligența artificială sunt același lucru?
- Cum se folosește învățarea profundă în gestionarea cheltuielilor corporative?
- Pentru a beneficia de această tehnologie, trebuie să ne antrenăm propriul model?
- Cu cât de multe date funcționează modelul?
- Concluzie: aduceți învățarea profundă în procesul dumneavoastră de gestionare a cheltuielilor
Învățarea profundă este o abordare de învățare automată bazată pe rețele neuronale artificiale cu mai multe straturi, inspirate de celulele nervoase din creierul uman. În acest articol vom rezuma pe scurt ce este învățarea profundă, iar apoi ne vom concentra pe întrebarea principală: unde atinge această tehnologie procesele financiare și de gestionare a cheltuielilor zilnice ale unei companii? Citirea bonurilor și facturilor, clasificarea cheltuielilor și prognozarea bugetului sunt cele trei domenii principale în care învățarea profundă ajunge concret pe biroul echipelor financiare.
Ce este învățarea profundă?
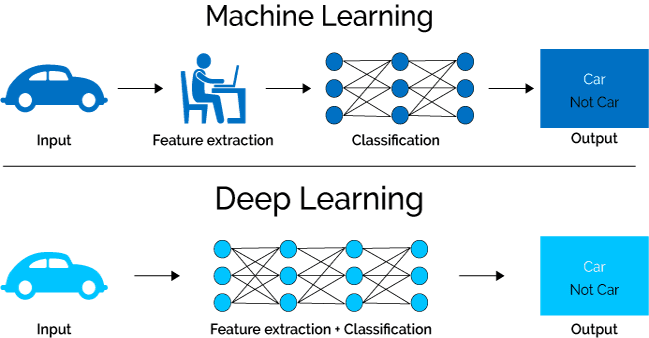
Spre deosebire de învățarea automată clasică, învățarea profundă folosește rețele neuronale artificiale formate din numeroase straturi. Termenul „profund” se referă tocmai la numărul mare al acestor straturi. În timp ce primele straturi captează indiciile simple din date (liniile dintr-o imagine de bon, conturul caracterelor), straturile mai profunde învață concepte mai abstracte (aceasta este o sumă totală, acela este numele unui furnizor).
Adevărata diferență este aceasta: în metodele tradiționale, un expert definește manual la ce caracteristici ale datelor să se uite. Învățarea profundă, în schimb, preia datele brute direct și descoperă singură ce este important. Această capacitate oferă un avantaj mare în cazul datelor care nu încap într-un tabel ordonat, precum imaginile, sunetul și textul liber. Bonurile mototolite, facturile în formate diferite și textele descriptive care trec zilnic prin mâinile unei echipe de contabilitate sunt exact acest tip de date.
Și procesul de învățare al rețelei neuronale se desfășoară după o logică intuitivă: modelul face o predicție, se măsoară eroarea dintre predicție și valoarea reală, iar reglajele interne ale rețelei se actualizează în direcția care reduce această eroare. După mii de repetări, modelul citește, de exemplu, tot mai precis suma de pe un bon.
Unde atinge învățarea profundă afacerea?
Detaliile arhitecturale ale învățării profunde (rețele convoluționale pentru datele vizuale, rețele recurente pentru datele secvențiale și modele cu mecanism de atenție) sunt subiectul echipelor tehnice. Pentru managerul financiar, ceea ce contează este ce muncă preiau aceste arhitecturi. Să privim prin trei exemple principale.
1. Citirea documentelor și a bonurilor: recunoașterea optică a caracterelor
Locul în care învățarea profundă atinge cel mai direct finanțele corporative este citirea documentelor. Tehnologia de recunoaștere optică a caracterelor poate recunoaște cu precizie ridicată diferite fonturi, scrisul de mână, chiar și textul de pe bonuri mototolite sau de calitate scăzută. Sistemele moderne nu doar citesc caracterele; ele înțeleg structura documentului, analizează tabelul și împart în câmpuri informațiile despre dată, sumă, cota de impozit și furnizor.
Pentru echipa financiară, rezultatul este clar: introducerea manuală în sistem a bonurilor și facturilor adunate de angajați este o muncă atât lentă, cât și predispusă la erori. Citirea documentelor bazată pe învățare profundă reduce acest pas la câteva secunde, diminuând la sursă problemele legate de bonuri pierdute, sume greșite și declarații întârziate. Povara introducerii manuale pentru companie am tratat-o separat în articolul despre costul ascuns în timp al introducerii cheltuielilor.
2. Clasificarea: a înregistra cheltuiala la locul potrivit
Al doilea mare domeniu de aplicare al învățării profunde este clasificarea. Înregistrarea unei cheltuieli în categoria „masă”, „transport” sau „cazare” pare simplă; însă a face acest lucru manual și consecvent pe mii de rânduri de date de cheltuieli este dificil. Modelele care învață din text și imagini sugerează automat categoria corectă și centrul de cost corect pentru o cheltuială, pe baza conținutului bonului, a numelui furnizorului și a sumei.
O clasificare corectă nu este doar o chestiune de ordine: vizibilitatea pe categorii face posibilă verificarea automată a regulilor din politica de cheltuieli. O cheltuială care încalcă politica ajunge în fața managerului deja marcată încă din faza de aprobare.
O extensie a aceleiași infrastructuri de clasificare este detectarea abaterilor: deoarece modelul a învățat tiparul obișnuit al cheltuielilor, poate marca situații precum bonuri duplicate, sume umflate sau furnizori neobișnuiți. Latura de proces a acestui subiect am analizat-o în detaliu în articolul despre frauda în cheltuieli.
3. Prognozarea: a anticipa bugetul și fluxul de numerar
Al treilea domeniu este prognozarea. Modelele de învățare profundă care lucrează cu date secvențiale sunt folosite pentru a anticipa evoluția cheltuielilor din perioada viitoare, pornind de la seriile istorice de cheltuieli. Acest lucru oferă un aport direct la două sarcini fundamentale ale echipei financiare: pe latura gestionării bugetului, a vedea din timp abaterile de la sfârșitul perioadei; pe latura fluxului de numerar, a planifica mai precis ieșirile lunilor următoare.
Aici este necesar să se stabilească corect așteptările: modelele de prognoză nu oferă cifre exacte; oferă o tendință și un interval. Valoarea lor stă tocmai în aceasta — micșorează surpriza și aduc decizia mai devreme.
Care este diferența dintre învățarea profundă și învățarea automată clasică?
Cele două concepte sunt adesea confundate; din perspectiva afacerii, diferențele pot fi rezumate astfel:
| Caracteristică | Învățare automată clasică | Învățare profundă |
|---|---|---|
| Extragerea caracteristicilor | Definită manual de un expert | Modelul învață singur din date |
| Necesarul de date | Poate funcționa cu mai puține date | Necesită seturi mari de date |
| Tipul de date potrivit | Date tabelare ordonate | Date libere precum imagini, text, sunet |
| Explicabilitate | Deciziile sunt mai ușor de urmărit | Justificarea deciziilor este mai închisă |
Învățarea profundă este un subset al învățării automate. În sarcinile cu date libere, precum citirea imaginilor de bonuri, învățarea profundă este net superioară; pe seturile de date mici și ordonate, în schimb, metodele clasice pot fi încă eficiente și mai economice.
La ce trebuie să fim atenți când o implementăm în organizație?
La transferul învățării profunde în procesele financiare trebuie să fim atenți la trei aspecte:
- Calitatea datelor: modelul este atât de bun pe cât sunt datele cu care este alimentat. Un sistem construit cu date de cheltuieli dezordonate și etichetate incomplet nu inspiră încredere; mai întâi trebuie stabilită disciplina datelor.
- Explicabilitate: în domenii supuse auditului, precum finanțele, „așa a spus modelul” nu este o justificare suficientă. Sunt de preferat configurațiile în care deciziile automate (de exemplu, marcarea unei cheltuieli) se combină cu aprobarea umană.
- Decizia de a construi sau a cumpăra: antrenarea propriului model necesită date, hardware specializat și o echipă de experți. Pentru majoritatea companiilor, calea corectă este să folosească o soluție de gestionare a cheltuielilor care oferă deja citirea documentelor și clasificarea, construindu-și propriul model doar dacă există o nevoie cu adevărat distinctivă.
Întrebări frecvente
Învățarea profundă și inteligența artificială sunt același lucru?
Nu. Inteligența artificială este conceptul cel mai larg; învățarea automată este o ramură a ei, iar învățarea profundă este un subset al învățării automate.
Cum se folosește învățarea profundă în gestionarea cheltuielilor corporative?
În trei moduri principale: citirea automată a bonurilor și facturilor prin recunoaștere optică a caracterelor, clasificarea automată a cheltuielilor pe categorie și centru de cost, prognozarea bugetului și a fluxului de numerar din date istorice. La acestea se adaugă detectarea abaterilor (marcarea cheltuielilor duplicate sau care încalcă politica).
Pentru a beneficia de această tehnologie, trebuie să ne antrenăm propriul model?
În majoritatea cazurilor, nu. Citirea documentelor și clasificarea cheltuielilor sunt domenii în care soluțiile gata făcute au ajuns la maturitate; antrenarea propriului model necesită investiții mari în date și expertiză și, de obicei, are sens doar pentru nevoi foarte specifice.
Cu cât de multe date funcționează modelul?
Depinde de problemă. Pentru sarcini simple de clasificare pot fi suficiente câteva mii de exemple; sarcinile complexe cu imagini și limbaj necesită mult mai multe. Învățarea prin transfer, care se bazează pe modele preantrenate, face posibilă obținerea de rezultate bune chiar și cu puține date.
Concluzie: aduceți învățarea profundă în procesul dumneavoastră de gestionare a cheltuielilor
Învățarea profundă a încetat să mai fie o curiozitate academică și a intrat în setul de instrumente zilnice ale echipei financiare. Citirea documentelor elimină introducerea manuală, clasificarea automatizează verificarea politicilor, prognozarea aduce mai devreme planul de buget și de numerar. Masraff, cu tehnologia sa de citire a documentelor bazată pe inteligență artificială, vă digitalizează bonurile și facturile în câteva secunde, vă clasifică automat cheltuielile și vă gestionează procesul de cheltuieli de la un capăt la altul. Pentru a vedea ce se poate face cu propriile date de cheltuieli, contactați-ne.